您现在的位置是:网站首页> AI人工智能
AI智能硬件技术收集
- AI人工智能
- 2026-10-19
- 2929人已阅读
AI智能硬件技术收集
小智AI机器人主页(各类板子固件下载等各类资料),源码主页,点击查看文档
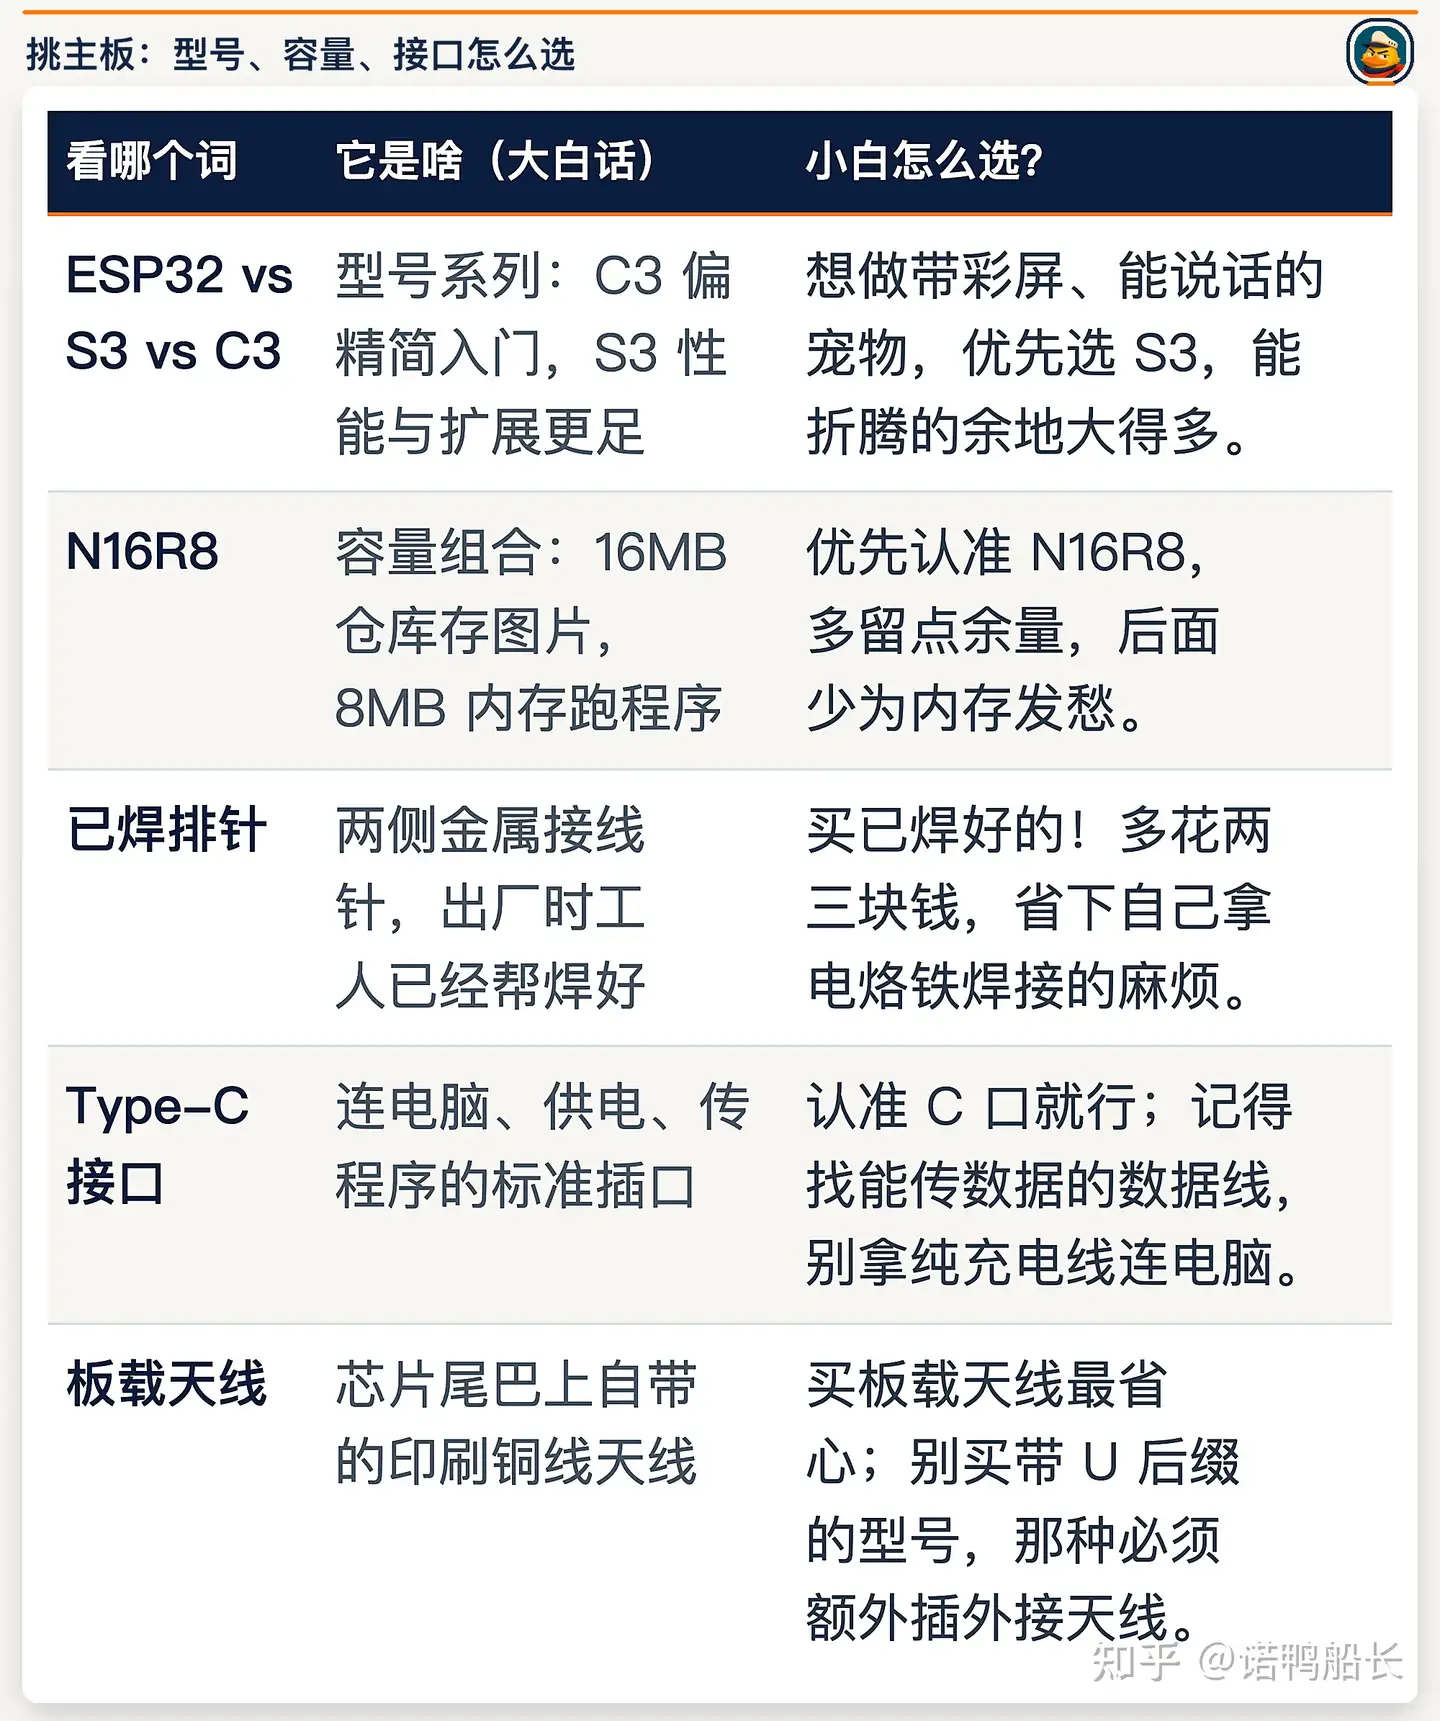
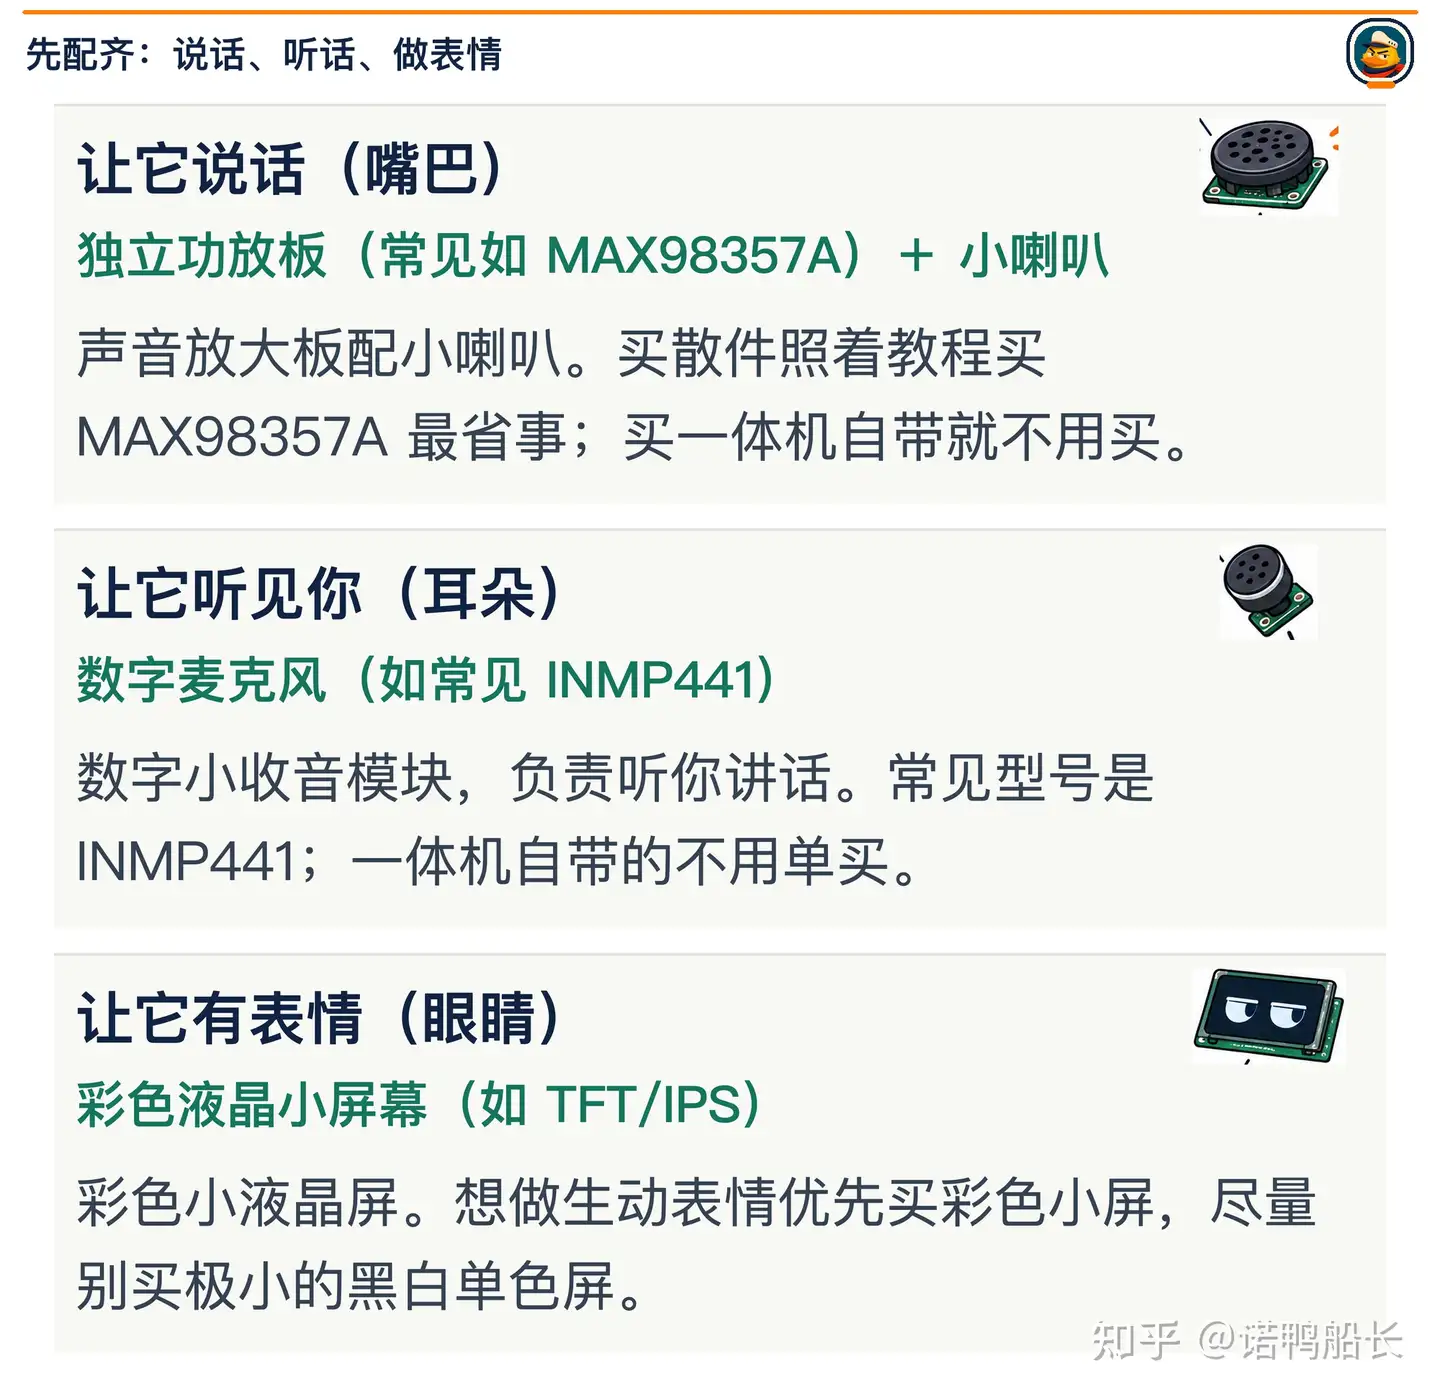
基于Arduino的ESP32-S3+inmp441全向麦克风模块
ESP32 + INMP441 + 实时语音识别完整方案(流式)
ESP32 录音 → WebSocket 上传 PCM → 服务端 ASR 识别 → 服务端 TTS 合成语音 → WebSocket 下发音频 → ESP32 播放
👍笔记本如何玩AI🟢一个视频解决笔记本玩AI的所有问题
笔记本+二手主机+扩展坞外置显卡
闲鱼购买主板:e5-2666v3x99板套装
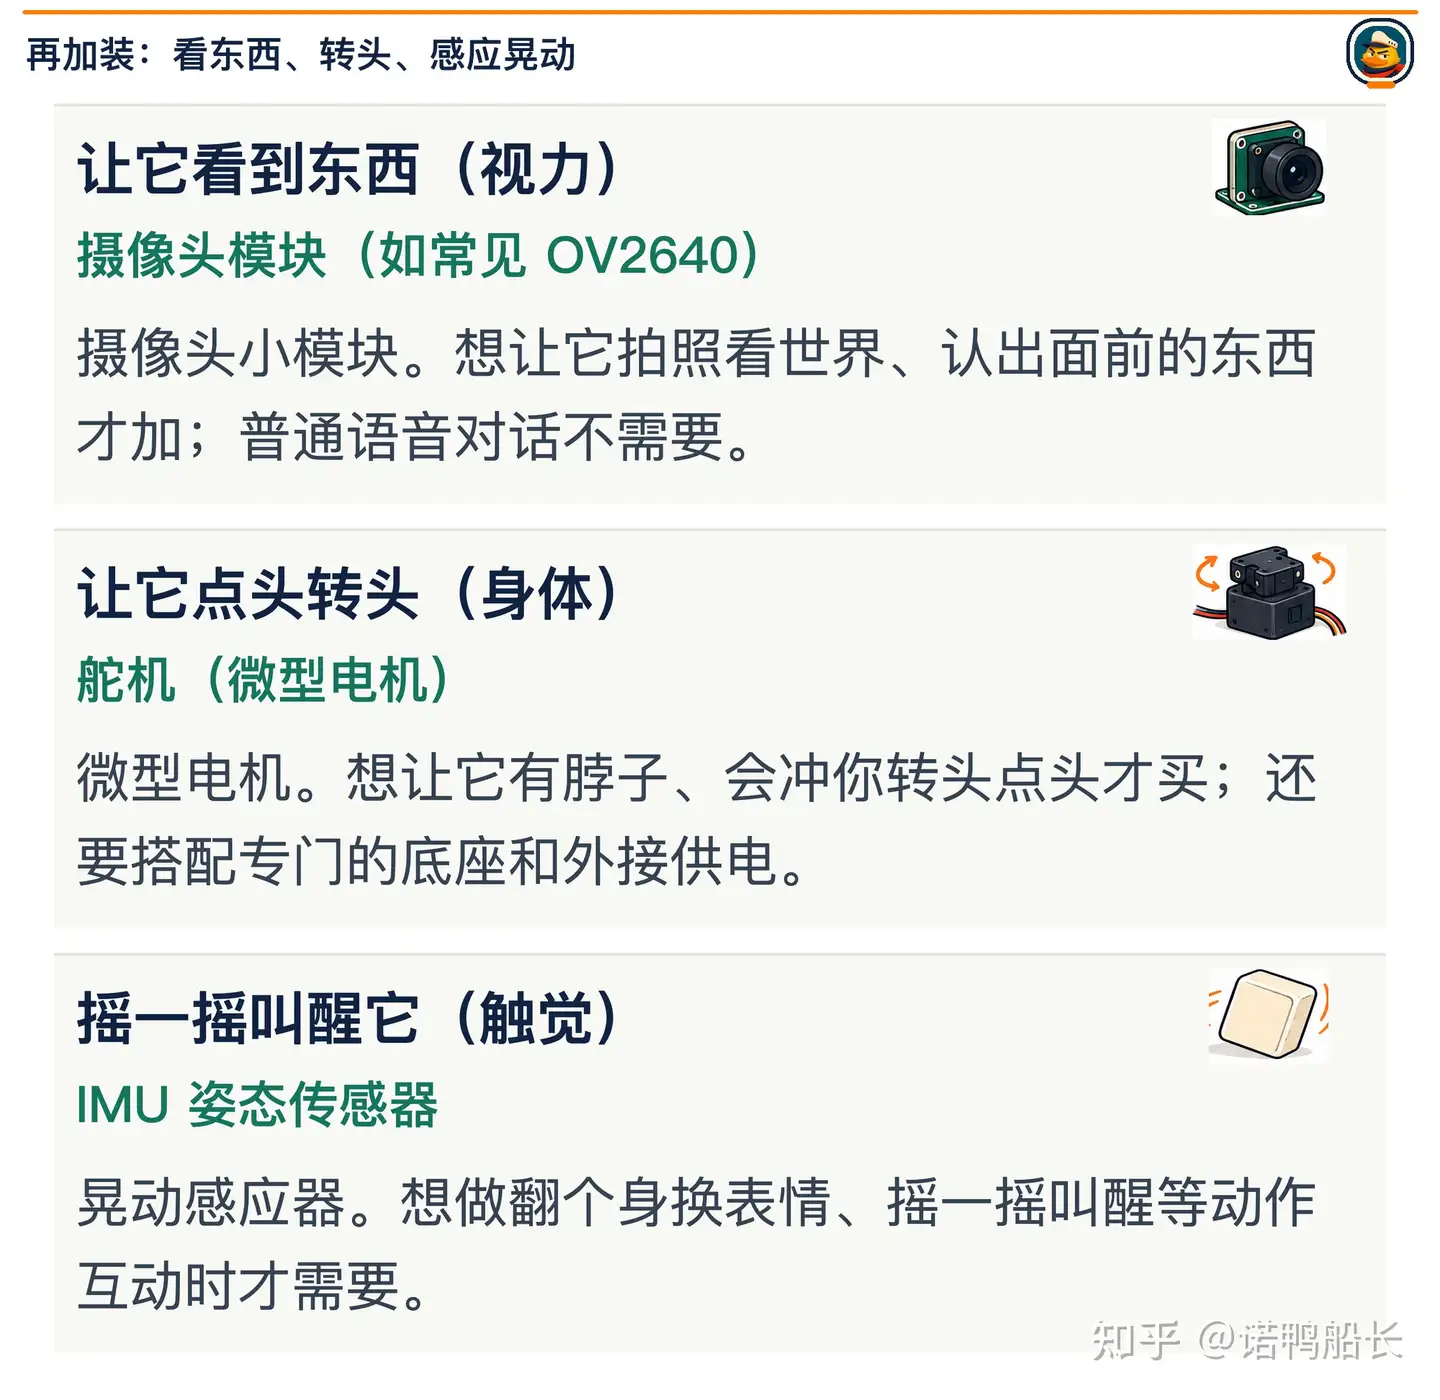
深度相机
深度摄像头和普通摄像头最大的区别在于其工作原理不同。普通摄像头只能够获取二维图像信息,无法获得物体的深度、厚度等三维信息。而深度摄像头则具有立体视觉感知系统,能够同时获取物体的空间位置和深度信息
工业相机和普通相机的区别:
1、工业相机的性能稳定可靠易于安装,结构紧凑结实不易损坏,可连续工作时间长,在较差的环境下也能使用,而普通相机是做不到这些的。
2、工业相机的快门时间非常短,可以抓拍高速运动的物体。高速旋转移动的物体,用工业相机抓拍一张图像,仍能够清晰辨别,这是普通相机做不到的。
3、工业相机的图像传感器是逐行扫描的,而普通的相机的图像传感器是隔行扫描的, 逐行扫描的图像传感器生产工艺比较复杂,成品率低,出货量少。
4、工业相机的帧率远远高于普通相机。工业相机每秒可以拍摄十幅到几百幅图片,而普通相机只能拍摄2-3幅图像,相差较大。
5、工业相机输出的是裸数据,其光谱范围也往往比较宽,比较适合进行高质量的图像处理算法,而普通相机拍摄的图片,其光谱范围只适合人眼视觉,图像质量较差,不利于分析处理。
6、 工业相机相对普通相机来说价格更贵。
面阵相机,感光芯片为面型,被测物体可以静止也可以运动,相机每次曝光就能够拍摄一张照片。运动拍照时,只要曝光时间(即拍摄一张照片的时间)足够短,能够小于被测物运动一个精度的时间,就能保证图像的精度。
线阵相机,感光芯片为线型,被测物体和相机间要有相对运动状态才能成像,有非常高的行频和横向分辨率,价格较高。
主要参数
感光芯片尺寸:面阵相机以芯片对角线的长度来度量,线阵相机以感光芯片的横向长度度量。
像素深度:是指存储每个像素所用的数据位数,对于黑白相机,像素深度定义了灰度值从全黑到过曝的灰阶数。常用8位像元深度的相机,输出的图像等级是2的八次方。即0-255,共256级,也有像元深度10位的相机,共1024级。
分辨率:感光芯片上有多少格像元,就是多少分辨率的相机,像素越多,分辨率越高,展示就越细节。
精度:用来描述图像上每个像素的实际物理尺寸。
帧率、行频:面阵相机的帧率是指一秒钟能拍多少张图像,线阵相机的行频是指一秒钟内相机扫描多少行。
增益:是指输入信号和输出信号的放大比例,通常用来提升整体亮度。
噪点:指感光芯片把光信号变成电信号并输出的过程中产生的不属于物体的部分影像。信噪比是指真实图像信号与图像噪声的比例。
光谱响应:感光芯片对光不同波长的响应能力不一样,一般会用响应曲线表示,可按感应光谱区分为:普通可见光相机,红外相机,紫外相机等。
触发:相机接收一次触发信号就会采集一次图像;还可以设置延时,收到触发信号过了设置好的时间再拍照。同样具备触发输出功能,拍照时候也可同时发送一个信号到其他的器件共同工作。
曝光时间:感光芯片接收光照射的时间,通常曝光时间越长图像越亮,但曝光时间过长可能产生拖影。曝光方式主要可分为行曝光和帧曝光。譬如:在被测物与相机相对运动时,线阵相机采用的就是逐行曝光,一次采集一行图像;面阵相机采用的就是帧曝光,一次采集一张图像。
相机的标准
相机通用协议(GenICam),目的是全行业实现相同应用编程接口。
通用传输层(GenTL):将传输层编程接口标准化;
通用应用编程接口(GenApi):用于设计相机的应用程序开发接口;
标准特点命名规范(SFNC):将相机子描述文件中的相机特点的名称、类型、意义和使用标准化;
传输接口:
GigE:应用最广泛的相机标准接口,基于以太网通信标准制定;
USB3.0:接口简单,即插即用,便于安装,高性能;
IEEE1394:俗称火线,苹果公司在1987年发行的串行标准,传输速度高且稳定;
Camera Link:一款强大、完善的通信接口方式,把相机和图像采集卡之间的连接标准化,包括提供数据传输、相机定时、串口通信和实时向相机发送信号;
同轴线缆(CoaXPress):其在1km的电缆长度内可提供的传输速度可达惊人的1Gbit/s,已经能够满足多数应用场景。
AI开发板怎么选
没钱:RK3566 RK3568 RK3562 RK3576 RK3588 RK3588S 华为Altlas开发板 香橙派AI pro
有钱:jetson Jetson AGX Orin
Seeed Grove Vision AI V2(图像识别,k230 k230d)
地瓜机器人RDK X5
代码模拟解析
已实现功能
Wi-Fi / ML307 Cat.1 4G
离线语音唤醒 ESP-SR
支持两种通信协议(Websocket 或 MQTT+UDP)
采用 OPUS 音频编解码
基于流式 ASR + LLM + TTS 架构的语音交互
声纹识别,识别当前说话人的身份 3D Speaker
OLED / LCD 显示屏,支持表情显示
电量显示与电源管理
支持多语言(中文、英文、日文)
支持 ESP32-C3、ESP32-S3、ESP32-P4 芯片平台
通过设备端 MCP 实现设备控制(音量、灯光、电机、GPIO 等)
通过云端 MCP 扩展大模型能力(智能家居控制、PC桌面操作、知识搜索、邮件收发等)
小智 AI 硬件端将语音推送到平台的技术流程主要涉及语音采集、音频编码、网络传输三个核心环节,以下从技术角度详细解析并提供关键代码示例(以 ESP32-S3 平台为例):
一、技术流程解析
语音采集
硬件端通过麦克风(如 INMP441 全向麦克风)采集模拟语音信号,经 ADC 转换为数字信号(PCM 格式),通常配置为:
采样率:16kHz(语音识别常用)
位深:16bit(单声道)
数据格式:Little-endian
音频预处理与编码
原始 PCM 数据体积较大(16kHz×16bit=32kb/s),需压缩编码(如 MP3、AAC 或 OPUS),减少网络传输带宽。ESP32 可通过硬件编解码模块或软件库(如libmp3lame)实现。
网络传输
通过 WiFi 或 4G 模块(如 EC20)将编码后的音频数据以流式传输方式发送到平台,常用协议:
HTTP POST:适合短语音片段(如唤醒词后的指令)
WebSocket:适合长对话(保持连接,实时推送)
二、关键代码实现(ESP32-S3 + Arduino 框架)
以下代码包含语音采集、MP3 编码、WiFi 传输的核心逻辑:
1. 依赖库与初始化
需安装 ESP32Audio(音频采集)、WiFi(网络)、libmp3lame(MP3 编码)库。
三、关键技术说明
音频采集优化
若使用模拟麦克风,需通过analogRead()采集并做降噪处理(如滑动平均滤波)。
I2S 接口可直接对接数字麦克风,减少干扰,代码中需正确配置BCLK_PIN(位时钟)、LRC_PIN(左右声道)、DOUT_PIN(数据输出)。
编码效率
MP3 编码在 ESP32 上可能占用较多 CPU,可改用更轻量的编码(如 ADPCM),或使用硬件编解码模块(如 ES8388)。
流式传输
长语音场景建议用 WebSocket(如WebSocketsClient库),保持连接并分帧发送,示例中 HTTP POST 适合短语音(10 秒内)。
平台交互
后端平台需提供音频接收接口,解析 MP3 后调用 ASR(语音识别)服务(如百度 AI、讯飞),再将文本返回给硬件端。
模拟代码:
硬件端:
#include <WiFi.h>
#include <HTTPClient.h>
#include <Audio.h> // 音频采集库
#include "lame.h" // MP3编码库
// 配置参数
const char* ssid = "你的WiFi名称";
const char* password = "你的WiFi密码";
const char* server_url = "https://你的平台API地址"; // 接收语音的后端接口
// 音频采集配置
AudioInputI2S audioInput; // 假设使用I2S麦克风(如INMP441)
const int sampleRate = 16000;
const int bitsPerSample = 16;
const int bufferSize = 1024; // 音频缓冲区大小
// MP3编码配置
lame_global_struct* lame;
unsigned char mp3Buffer[bufferSize * 2]; // 编码后缓冲区
// WiFi客户端
WiFiClient client;
HTTPClient http;
void setup() {
Serial.begin(115200);
// 1. 初始化WiFi
WiFi.begin(ssid, password);
while (WiFi.status() != WL_CONNECTED) {
delay(500);
Serial.print(".");
}
Serial.println("WiFi连接成功");
// 2. 初始化音频采集
audioInput.setPinout(BCLK_PIN, LRC_PIN, DOUT_PIN); // 配置I2S引脚(依硬件定义)
audioInput.setSampleRate(sampleRate);
audioInput.setBitsPerSample(bitsPerSample);
// 3. 初始化MP3编码器
lame = lame_init();
lame_set_in_samplerate(lame, sampleRate);
lame_set_num_channels(lame, 1); // 单声道
lame_set_brate(lame, 32); // 比特率32kbps
lame_init_params(lame);
}
void loop() {
if (WiFi.status() != WL_CONNECTED) {
Serial.println("WiFi断开,重新连接...");
WiFi.reconnect();
delay(1000);
return;
}
// 4. 采集PCM数据
int16_t pcmBuffer[bufferSize];
int bytesRead = audioInput.read(pcmBuffer, bufferSize);
if (bytesRead > 0) {
// 5. PCM转MP3编码
int mp3Size = lame_encode_buffer(lame,
pcmBuffer, // 左声道PCM
NULL, // 右声道(单声道为NULL)
bytesRead, // 样本数
mp3Buffer, // 输出缓冲区
sizeof(mp3Buffer));
if (mp3Size > 0) {
// 6. 发送MP3数据到平台
sendAudioToServer(mp3Buffer, mp3Size);
}
}
}
// 发送音频数据到平台
void sendAudioToServer(unsigned char* data, int len) {
http.begin(client, server_url);
http.addHeader("Content-Type", "audio/mpeg"); // 声明MP3格式
http.addHeader("Authorization", "Bearer 你的API密钥"); // 平台认证
int httpCode = http.POST(data, len);
if (httpCode == 200) {
Serial.println("音频推送成功");
String response = http.getString();
Serial.println("平台响应:" + response); // 可解析平台返回的文本结果
} else {
Serial.printf("推送失败,错误码:%d\n", httpCode);
}
http.end();
}
服务端模拟代码:
from fastapi import FastAPI, UploadFile, File, HTTPException
from fastapi.responses import JSONResponse
import whisper
import openai
import os
import tempfile
from pydantic import BaseModel
# 配置项(请替换为实际值)
OPENAI_API_KEY = "你的OpenAI API密钥"
WHISPER_MODEL = "base" # 可选:tiny/base/small/medium/large(精度递增,资源需求递增)
AI_MODEL = "gpt-3.5-turbo" # 或其他模型如gpt-4
# 初始化服务
app = FastAPI(title="小智AI语音处理服务")
openai.api_key = OPENAI_API_KEY
# 加载Whisper语音识别模型
asr_model = whisper.load_model(WHISPER_MODEL)
class AIChatResponse(BaseModel):
text: str # AI回复文本
request_id: str # 请求唯一标识
@app.post("/api/voice/process", response_model=AIChatResponse)
async def process_voice(file: UploadFile = File(...)):
"""接收语音文件,转文字后调用AI处理"""
try:
# 1. 验证文件格式
if not file.filename.endswith((".mp3", ".wav", ".m4a")):
raise HTTPException(status_code=400, detail="仅支持MP3/WAV/M4A格式音频")
# 2. 保存临时音频文件
with tempfile.NamedTemporaryFile(delete=False, suffix=".mp3") as temp_file:
content = await file.read()
temp_file.write(content)
temp_file_path = temp_file.name
# 3. 语音识别(Whisper)
# 自动检测语言并转文字
result = asr_model.transcribe(temp_file_path, language="zh") # 强制中文识别
recognized_text = result["text"].strip()
print(f"识别到文本: {recognized_text}")
# 4. 调用AI模型处理
ai_response = openai.ChatCompletion.create(
model=AI_MODEL,
messages=[
{"role": "system", "content": "你是小智AI助手,用简洁友好的语言回复用户"},
{"role": "user", "content": recognized_text}
],
temperature=0.7 # 控制回复随机性
)
ai_text = ai_response.choices[0].message["content"].strip()
# 清理临时文件
os.unlink(temp_file_path)
return {
"text": ai_text,
"request_id": ai_response.id # 使用OpenAI的请求ID作为唯一标识
}
except Exception as e:
print(f"处理错误: {str(e)}")
raise HTTPException(status_code=500, detail=f"服务处理失败: {str(e)}")
# 启动服务(本地测试用)
if __name__ == "__main__":
import uvicorn
uvicorn.run(app, host="0.0.0.0", port=8000) # 监听所有网络接口,端口8000
终端解码播放
#include "opus/opus.h"
#include "driver/i2s.h"
#include <stdlib.h>
#include <string.h>
// 音频配置参数
#define SAMPLE_RATE 16000 // 采样率:16kHz
#define CHANNELS 1 // 单声道
#define FRAME_SIZE 320 // 帧大小(16000Hz下20ms对应320样本)
#define MAX_PACKET_SIZE 1024 // 最大OPUS数据包大小
// OPUS解码器实例
static OpusDecoder *decoder = NULL;
static int decoder_error;
// 初始化OPUS解码器
bool opus_decoder_init() {
// 创建OPUS解码器
decoder = opus_decoder_create(SAMPLE_RATE, CHANNELS, &decoder_error);
if (decoder_error != OPUS_OK || decoder == NULL) {
printf("OPUS decoder init failed: %d\n", decoder_error);
return false;
}
// 初始化I2S音频输出(根据硬件配置调整)
i2s_config_t i2s_config = {
.mode = I2S_MODE_MASTER | I2S_MODE_TX,
.sample_rate = SAMPLE_RATE,
.bits_per_sample = I2S_BITS_PER_SAMPLE_16BIT,
.channel_format = I2S_CHANNEL_FMT_ONLY_LEFT, // 单声道
.communication_format = I2S_COMM_FORMAT_STAND_I2S,
.dma_buf_count = 4,
.dma_buf_len = 1024,
.intr_alloc_flags = ESP_INTR_FLAG_LEVEL1
};
i2s_pin_config_t pin_config = {
.bck_io_num = 26, // 音频时钟线(根据硬件定义)
.ws_io_num = 25, // 声道选择线
.data_out_num = 22,// 数据输出线
.data_in_num = -1 // 不使用输入
};
if (i2s_driver_install(I2S_NUM_0, &i2s_config, 0, NULL) != ESP_OK) {
printf("I2S driver install failed\n");
return false;
}
if (i2s_set_pin(I2S_NUM_0, &pin_config) != ESP_OK) {
printf("I2S set pin failed\n");
i2s_driver_uninstall(I2S_NUM_0);
return false;
}
printf("OPUS decoder and I2S initialized\n");
return true;
}
// 解码并播放OPUS音频数据
void opus_decode_and_play(uint8_t *opus_data, int data_len) {
if (!decoder || !opus_data || data_len <= 0) return;
// 分配PCM输出缓冲区(16位采样)
int16_t pcm_buffer[FRAME_SIZE * 2]; // 预留双倍空间防止溢出
memset(pcm_buffer, 0, sizeof(pcm_buffer));
// 解码OPUS数据为PCM
int decoded_samples = opus_decode(
decoder,
opus_data,
data_len,
pcm_buffer,
FRAME_SIZE,
0 // 不需要向前兼容
);
if (decoded_samples < 0) {
printf("OPUS decode error: %d\n", decoded_samples);
return;
}
// 通过I2S播放PCM数据
size_t bytes_written;
i2s_write(I2S_NUM_0,
pcm_buffer,
decoded_samples * sizeof(int16_t),
&bytes_written,
portMAX_DELAY);
}
// 释放解码器资源
void opus_decoder_destroy() {
if (decoder) {
opus_decoder_destroy(decoder);
decoder = NULL;
}
i2s_driver_uninstall(I2S_NUM_0);
}
小智问题收集
点击官方问题集(编译配置等问题都集成在此在线文档中)
服务端基础框架是开源的,但是大模型是私有训练和部署的,使用的是阿里开放的QWen 72B大模型,需要自行对接和训练,部署大概需要4张4090显卡(24*4=96G显存)以上才能正常运行,具体自行了解实现。
服务端开源地址:https://github.com/78/xiaozhi
核心开源仓库地址
1. 官方主仓库(ESP32 硬件 + 服务端一体化)
这是小智 AI 最核心的开源项目,包含硬件端(ESP32)和配套服务端代码:
GitHub 地址:https://github.com/espressif/xiaozhi-esp32
核心内容:ESP32 语音交互固件、Python 版服务端(对接大模型 API)、部署文档、硬件接线说明
适配模型:通义千问、DeepSeek、智谱 AI、豆包等主流大模型
2. 社区优化版服务端(Docker 化部署)
适合快速部署的 Docker 版本,降低环境配置成本:
GitHub 地址:https://github.com/xiaozhi-project/xiaozhi-server-docker
核心内容:一键部署的 Docker Compose 配置、多模型适配插件、WebSocket 通信优化
支持平台:Linux/Windows/macOS,兼容各类云服务器
3. 多语言服务端实现
社区提供的不同编程语言版本,满足个性化开发需求:
Go 版本:https://github.com/lixiangyun/xiaozhi-server-go
Java 版本:https://gitee.com/miaodaba/xiaozhi-server-java
使用注意事项
克隆仓库前确保已安装 Git,终端执行克隆命令示例:
bash
运行
git clone https://github.com/espressif/xiaozhi-esp32.git
服务端运行需配置大模型 API 密钥(如通义千问、豆包的 API Key),具体步骤见仓库内 README.md;
若部署到云服务器,需开放对应端口(默认 WebSocket 端口 8080),并配置安全组规则。
总结
官方核心仓库优先选espressif/xiaozhi-esp32,包含完整的硬件 + 服务端方案;
想快速部署选 Docker 版本xiaozhi-project/xiaozhi-server-docker,无需手动配置环境;
有特定编程语言需求可选择 Go/Java 版本的社区仓库。
ESP32 + INMP441 + 实时语音识别完整方案(流式)
# ESP32 + INMP441 + 实时语音识别完整方案(流式)
核心难点:**原版 OpenAI Whisper 没有原生流式 API**,直接用它做实时很麻烦。
两个成熟路线:
1. **FunASR Paraformer(首选,中文流式,最简单,延迟低)**
2. **faster-whisper + VAD + 滑动窗口(备选,多语种,代码复杂一点)**
> 音频规格不变:ESP32 输出 **16000Hz,mono,int16 小端裸 PCM**
## 整体数据流
```
INMP441 I2S采集 → ESP32组装PCM帧 → WebSocket(推荐)/TCP上传二进制PCM分片
→ 服务端环形缓冲区持续接收PCM
→ 送入流式ASR引擎,边收音频边输出文字
```
> 推荐通信:**WebSocket**,二进制帧传输,很多 ASR 流式 demo 原生适配;比 TCP 好处理粘包。
>
> ESP32 发送帧:建议 **512 个 int16 样本(32ms,1024 字节)一包**。
## 关键概念:流式 ASR 原理
FunASR 的 paraformer-streaming 是**原生流式模型**:
模型内部维护状态,你不断喂 PCM 片段,它持续返回**中间候选文本**;一句话结束后输出最终结果。
- 不需要等整段语音结束才推理
- 模型内部按 20ms 帧做特征计算
> Whisper 本身不是流式模型。如果强行做实时,要用滑动窗口 + VAD(端点检测),会有窗口延迟,中文性能不如 FunASR。
# 方案一:FunASR 流式识别(推荐,优先看这个)
## 1、服务端环境准备
```
pip install funasr
```
## 2、Python WebSocket 服务端(接收 ESP32 二进制 PCM + FunASR 流式)
```
import asyncio
import websockets
from funasr import AutoModel
# 加载流式paraformer中文模型
model = AutoModel(model="paraformer-streaming", model_revision="v2.0.4")
# 流式推理初始化
cache = {}
chunk_size = [0, 10, 5] # 流式参数:[0, 10,5]对应600ms, 300ms, 300ms
print("服务启动,等待ESP32连接 ws://0.0.0.0:8765")
async def handle_client(websocket):
global cache
cache = {} # 重置模型状态,新用户新会话
print("ESP32已连接")
while True:
# 接收ESP32发来的二进制PCM(int16裸流)
pcm_data = await websocket.recv()
# 送入流式ASR
res = model.generate(
input=pcm_data,
cache=cache,
chunk_size=chunk_size,
is_final=False,
fs=16000
)
text = res[0]["text"]
print(f"实时识别结果:{text}")
async def main():
async with websockets.serve(handle_client, "0.0.0.0", 8765):
await asyncio.Future()
asyncio.run(main())
```
>
> 注意:`is_final=False` 持续流式输入;当检测到静音(VAD)一句话结束,调用一次`is_final=True`输出最终文本,并清空 cache。
## 3、ESP32 WebSocket 客户端发送 PCM 片段(Arduino)
需要库:`WebSockets`(库管理器安装,由 Links2024 维护)
```
#include <WebSocketsClient.h>
#include <WiFi.h>
#include "driver/i2s.h"
#define WIFI_SSID "xxx"
#define WIFI_PASS "xxx"
#define WS_HOST "你的电脑IP"
#define WS_PORT 8765
#define WS_PATH "/"
WebSocketsClient webSocket;
#define I2S_PORT I2S_NUM_0
#define BCLK_PIN 26
#define WS_PIN 25
#define SD_PIN 22
#define SAMPLE_RATE 16000
#define FRAME_SAMPLES 512 // 512 int16样本,32ms
int16_t frame[FRAME_SAMPLES];
void webSocketEvent(WStype_t type, uint8_t * payload, size_t length) {
switch(type) {
case WStype_CONNECTED:
Serial.println("WebSocket 已连上服务端");
break;
case WStype_DISCONNECTED:
Serial.println("断开连接");
break;
default: break;
}
}
void setup() {
Serial.begin(115200);
WiFi.begin(WIFI_SSID, WIFI_PASS);
while(WiFi.status() != WL_CONNECTED) delay(500);
Serial.println("WiFi连上");
webSocket.begin(WS_HOST, WS_PORT, WS_PATH);
webSocket.onEvent(webSocketEvent);
webSocket.setReconnectInterval(2000);
// I2S初始化 INMP441
i2s_driver_install(I2S_PORT, &(i2s_config_t){
.mode = (i2s_mode_t)(I2S_MODE_MASTER | I2S_MODE_RX),
.sample_rate = SAMPLE_RATE,
.bits_per_sample = I2S_BITS_PER_SAMPLE_32BIT,
.channel_format = I2S_CHANNEL_FMT_ONLY_LEFT,
.communication_format = I2S_COMM_FORMAT_STAND_I2S,
.intr_alloc_flags = ESP_INTR_FLAG_LEVEL1,
.dma_buf_count = 8,
.dma_buf_len = 128,
}, 0, NULL);
i2s_set_pin(I2S_PORT, &(i2s_pin_config_t){
.bck_io_num = BCLK_PIN,
.ws_io_num = WS_PIN,
.data_out_num = I2S_PIN_NO_CHANGE,
.data_in_num = SD_PIN
});
}
void loop() {
webSocket.loop();
int32_t raw;
size_t bytesRead;
i2s_read(I2S_PORT, &raw, sizeof(raw), &bytesRead, portMAX_DELAY);
int32_t s24 = raw & 0x00FFFFFF;
if(s24 & (1 << 23)) s24 |= 0xFF000000;
int16_t s16 = s24 >> 8;
static int idx = 0;
frame[idx++] = s16;
if(idx >= FRAME_SAMPLES){
// 攒满一帧,二进制发送PCM
webSocket.sendBIN((uint8_t*)frame, sizeof(frame));
idx = 0;
}
}
```
## 4、VAD 静音检测(重要!一句话结束判断)
上面代码缺少静音检测。
流式模型需要:
- 持续发送音频 `is_final=False`
- 检测静音持续一段时间(例如 300ms 静音)→ 调用 `is_final=True`,输出最终文本,重置 cache,准备下一轮识别
FunASR 自带 VAD,或者可以用`silero-vad`(轻量,Python)做静音检测,**推荐 silero-vad**。
---
# 方案二:想用 Whisper 做实时(不推荐首选,了解即可)
原版 whisper 不能流式,一般用 `faster-whisper + silero-vad + 滑动窗口`
思路:
1. 持续接收 ESP32 PCM,存入环形 buffer
2. silero-vad 检测有没有人声
3. 检测到静音代表一句话结束,截取这段音频送入 faster-whisper 识别
👉 **本质是「近实时,一句话识别」,不是原生流式,会多几百 ms 延迟**,适合多语种场景。
## 方案对比
表格
| 方案 | 延迟 | 中文 | 多语言 | 复杂度 |
| --- | --- | --- | --- | --- |
| FunASR Paraformer-streaming | 低 (100~300ms) | ⭐⭐⭐⭐⭐ | 一般 | 低,首选 |
| faster-whisper+VAD | 较高 (300~800ms) | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 中等 |
# 必须注意的坑
1. **发送必须是二进制 BIN,不能转文本**:`sendBIN()`,不要 sendTXT。
2. WiFi 丢包:WebSocket 底层 TCP,丢包会重传;弱 WiFi 会增加延迟。
3. 音频时序:**样本不能丢、不能错位**。一旦丢样本,识别直接乱码。
4. 模型 cache:每一轮对话结束,必须重置 cache,否则上下文残留,识别错乱。
5. INMP441 接地:底噪大,VAD 会误判,识别效果差。
ESP32 录音 → WebSocket 上传 PCM → 服务端 ASR 识别 → 服务端 TTS 合成语音 → WebSocket 下发音频 → ESP32 播放
整个链路:
`INMP441录音(16k mono int16 PCM) → ESP32 WebSocket上传二进制PCM → Python服务端FunASR流式识别 → 拿到文本 → TTS生成应答音频(16k mono int16 PCM) → WebSocket下发二进制PCM给ESP32 → ESP32 I2S功放播放声音`
> 硬件新增:**I2S DAC 模块(如 UDA1334A)**,用来输出音频。INMP441 是 I2S 输入(麦克风),UDA1334A 是 I2S 输出(播放)。
> 音频格式统一:**全部 16000Hz, mono, int16 小端 PCM**,格式统一,省去格式转换,减少复杂度。
## 硬件接线新增(UDA1334A I2S DAC)
表格
| UDA1334A | ESP32 |
| --- | --- |
| VCC | 3.3V |
| GND | GND |
| BCLK | GPIO27 |
| LRC(WS) | GPIO26 |
| DATA | GPIO25 |
> ⚠️ 注意引脚分配:麦克风 INMP441 和 DAC 共用 ESP32 I2S1(I2S_NUM_1)或者分开两个 I2S 端口
> 推荐分开硬件 I2S:
> - I2S_NUM0:INMP441 麦克风采集(RX)
> - I2S_NUM1:UDA1334A DAC 播放(TX)
> ESP32 有两组硬件 I2S,可以同时跑采集 + 播放。
## 整体逻辑说明
1. ESP32 上行:采集麦克风 PCM,`sendBIN`发给服务端(语音识别)
2. Python 服务端:
- 接收麦克风 PCM → FunASR 识别出文字
- 将识别文本送入 TTS,生成应答语音裸 PCM(16k mono int16)
- **通过同一条 WebSocket 连接,下发二进制 PCM 给 ESP32**
3. ESP32 下行:WebSocket 收到服务端下发的 TTS 音频 PCM,送入 I2S DAC 直接播放
>
> TTS 选型:
> - 本地轻量 TTS:**edge-tts(微软 edge 在线 TTS,简单,免费)**,直接输出 wav,再提取裸 PCM
> - 本地离线 TTS:piper,不用联网,适合私有化
# 一、Python 服务端完整代码(WebSocket,FunASR 识别 + Edge-TTS 合成 + 下发音频 PCM)
```
import asyncio
import websockets
import funasr
from funasr import AutoModel
import edge_tts
import io
import wave
# ========== 配置 ==========
WS_PORT = 8765
SAMPLING_RATE = 16000
model = AutoModel(model="paraformer-streaming", model_revision="v2.0.4")
cache = {}
chunk_size = [0,10,5]
# TTS 生成 16k mono int16 裸PCM
async def text2pcm(text:str) -> bytes:
communicate = edge_tts.Communicate(text, voice="zh-CN-YunyangNeural")
buf = io.BytesIO()
async for chunk in communicate.stream():
if chunk["type"] == "audio":
buf.write(chunk["data"])
buf.seek(0)
# 读取wav,提取裸PCM
wf = wave.open(buf, 'rb')
assert wf.getframerate() == 16000
assert wf.getnchannels() ==1
assert wf.getsampwidth() ==2
pcm_data = wf.readframes(wf.getnframes())
wf.close()
return pcm_data
async def handle_client(websocket):
global cache
cache = {}
print("ESP32已连接")
recv_pcm_buffer = bytearray()
try:
while True:
# 1. 接收ESP32上传的麦克风PCM二进制
data = await websocket.recv()
if isinstance(data, bytes):
recv_pcm_buffer.extend(data)
# 送入FunASR流式识别
res = model.generate(
input=data,
cache=cache,
chunk_size=chunk_size,
is_final=False,
fs=SAMPLING_RATE
)
text = res[0]["text"]
print(f"实时识别:{text}")
# ===== 模拟:检测一句话结束(实际项目这里放Silero VAD判断静音)=====
# 演示:当识别文本不为空,简单触发TTS应答(实际项目VAD触发is_final=True)
if len(text) > 3:
print(f"【一句话结束,生成TTS应答】应答文本:{text}")
# 提交final,结束本轮识别
model.generate(input=b"", cache=cache, chunk_size=chunk_size, is_final=True, fs=SAMPLING_RATE)
# 生成TTS音频PCM
reply_pcm = await text2pcm(f"你说的是:{text}")
# 下发音频PCM给ESP32,二进制包
await websocket.send(reply_pcm)
print(f"下发TTS音频,字节长度: {len(reply_pcm)}")
# 重置ASR缓存,准备下一轮对话
cache = {}
recv_pcm_buffer.clear()
except websockets.exceptions.ConnectionClosed:
print("ESP32断开连接")
async def main():
async with websockets.serve(handle_client, "0.0.0.0", WS_PORT):
print(f"WebSocket服务启动 ws://0.0.0.0:{WS_PORT}")
await asyncio.Future()
if __name__ == "__main__":
asyncio.run(main())
```
安装依赖:
```
pip install funasr websockets edge-tts
```
> 注意:edge-tts 需要联网;如果需要离线 TTS,替换为 piper。
# 二、ESP32 Arduino 代码(I2S 麦克风采集 + WebSocket 上传 PCM + 接收 TTS 音频 + I2S 播放)
> 库依赖:`WebSocketsClient`
> I2S_NUM0:INMP441 麦克风输入
> I2S_NUM1:UDA1334A DAC 音频输出
```
#include <WebSocketsClient.h>
#include <WiFi.h>
#include "driver/i2s.h"
// WiFi配置
#define WIFI_SSID "你的wifi"
#define WIFI_PASS "wifi密码"
#define WS_HOST "你的电脑IP"
#define WS_PORT 8765
#define WS_PATH "/"
WebSocketsClient webSocket;
// ========= I2S0 INMP441麦克风(采集)=========
#define I2S_MIC I2S_NUM_0
#define BCLK_MIC 26
#define WS_MIC 25
#define SD_MIC 22
#define SAMPLE_RATE 16000
#define FRAME_SAMPLES 512
int16_t mic_frame[FRAME_SAMPLES];
// ========= I2S1 UDA1334A DAC(播放)=========
#define I2S_DAC I2S_NUM_1
#define BCLK_DAC 27
#define WS_DAC 26
#define DATA_DAC 25
// 播放环形缓冲区,缓存服务端下发的TTS PCM
#define PLAY_BUF_SIZE 2048
int16_t playBuffer[PLAY_BUF_SIZE];
volatile int play_wr_ptr = 0;
volatile int play_rd_ptr = 0;
// WebSocket事件回调
void webSocketEvent(WStype_t type, uint8_t * payload, size_t length) {
switch(type) {
case WStype_CONNECTED:
Serial.println("WebSocket已连上服务端");
break;
case WStype_DISCONNECTED:
Serial.println("断开连接");
break;
case WStype_BIN:
{
// 收到服务端下发的TTS音频PCM,写入播放环形缓冲区
int16_t* pcm = (int16_t*)payload;
int samples = length / 2;
for(int i=0;i<samples;i++){
int next = (play_wr_ptr + 1) % PLAY_BUF_SIZE;
if(next != play_rd_ptr){
playBuffer[play_wr_ptr] = pcm[i];
play_wr_ptr = next;
}
}
break;
}
default: break;
}
}
// 初始化I2S麦克风
void initI2SMic(){
i2s_driver_install(I2S_MIC, &(i2s_config_t){
.mode = (i2s_mode_t)(I2S_MODE_MASTER | I2S_MODE_RX),
.sample_rate = SAMPLE_RATE,
.bits_per_sample = I2S_BITS_PER_SAMPLE_32BIT,
.channel_format = I2S_CHANNEL_FMT_ONLY_LEFT,
.communication_format = I2S_COMM_FORMAT_STAND_I2S,
.intr_alloc_flags = ESP_INTR_FLAG_LEVEL1,
.dma_buf_count = 8,
.dma_buf_len = 128,
},0,NULL);
i2s_set_pin(I2S_MIC, &(i2s_pin_config_t){
.bck_io_num = BCLK_MIC,
.ws_io_num = WS_MIC,
.data_out_num = I2S_PIN_NO_CHANGE,
.data_in_num = SD_MIC
});
}
// 初始化I2S DAC播放
void initI2SDac(){
i2s_driver_install(I2S_DAC, &(i2s_config_t){
.mode = (i2s_mode_t)(I2S_MODE_MASTER | I2S_MODE_TX),
.sample_rate = SAMPLE_RATE,
.bits_per_sample = I2S_BITS_PER_SAMPLE_16BIT,
.channel_format = I2S_CHANNEL_FMT_ONLY_LEFT,
.communication_format = I2S_COMM_FORMAT_STAND_I2S,
.intr_alloc_flags = ESP_INTR_FLAG_LEVEL1,
.dma_buf_count = 8,
.dma_buf_len = 128,
},0,NULL);
i2s_set_pin(I2S_DAC, &(i2s_pin_config_t){
.bck_io_num = BCLK_DAC,
.ws_io_num = WS_DAC,
.data_out_num = DATA_DAC,
.data_in_num = I2S_PIN_NO_CHANGE
});
}
void setup() {
Serial.begin(115200);
WiFi.begin(WIFI_SSID, WIFI_PASS);
while(WiFi.status() != WL_CONNECTED) delay(500);
Serial.println("WiFi connected");
webSocket.begin(WS_HOST, WS_PORT, WS_PATH);
webSocket.onEvent(webSocketEvent);
webSocket.setReconnectInterval(2000);
initI2SMic();
initI2SDac();
}
void loop() {
webSocket.loop();
size_t bytesRead;
int32_t raw;
// ========== 麦克风采集上行 ==========
i2s_read(I2S_MIC, &raw, sizeof(raw), &bytesRead, portMAX_DELAY);
int32_t s24 = raw & 0x00FFFFFF;
if(s24 & (1 << 23)) s24 |= 0xFF000000;
int16_t s16 = s24 >> 8;
static int idx = 0;
mic_frame[idx++] = s16;
if(idx >= FRAME_SAMPLES){
webSocket.sendBIN((uint8_t*)mic_frame, sizeof(mic_frame));
idx = 0;
}
// ========== 播放下行TTS音频 ==========
if(play_rd_ptr != play_wr_ptr){
int16_t sample = playBuffer[play_rd_ptr];
size_t wb;
i2s_write(I2S_DAC, &sample, sizeof(sample), &wb, 100);
play_rd_ptr = (play_rd_ptr + 1) % PLAY_BUF_SIZE;
}
}
```
## 三、重点工程问题 & 坑点
### 1. 回声问题(最重要!)
ESP32 扬声器播放声音会被 INMP441 麦克风拾取,形成**回声**,ASR 识别会把 TTS 的应答当成用户语音。
解决方案:
1. 硬件:麦克风和喇叭物理远离,增加隔音
2. 软件:**半双工控制**:ESP32 播放 TTS 的时候,**暂停麦克风采集、暂停上传音频**;播放完毕再打开麦克风采集。✅ 最简单有效的方案!
> 推荐逻辑:
> - 收到 TTS 音频包 → 关闭麦克风上行采集,播放语音
> - 播放缓冲区清空完毕 → 重新开启麦克风采集,等待用户说话
### 2. 半双工逻辑改造建议(推荐加上)
增加全局标记 `bool isPlaying = false;`
- 收到服务端下发 TTS 音频 → `isPlaying=true`,暂停采集上传
- 播放缓冲区空了 → `isPlaying=false`,恢复麦克风采集上传
### 3. 音频时序
- 上行麦克风:16k mono int16
- 下行 TTS 播放:必须**同样 16k mono int16**,采样率不一致会变快 / 变慢、变调。
### 4. 环形缓冲区
ESP32 接收 TTS 音频存入环形缓冲,防止 I2S 播放速度和 websocket 下发速度不匹配,防止爆音。
### 5. 通信协议优化
现在是同一条 websocket 上行 + 下行。
区分包类型:增加简单协议头,例如`[1字节标记 + payload]`
- 0x01:麦克风上行 PCM
- 0x02:TTS 下行播放 PCM
防止后续扩展功能时数据包混淆。
## 可选扩展
1. 增加 Silero VAD,自动判断用户说话结束,不再是简单文本长度触发 TTS
2. 替换 edge-tts 为本地离线 Piper TTS,脱离公网
3. 增加半双工开关,解决回声
4. 增加音量控制、静音检测
上一篇:AI视觉技术应用与开发收集
下一篇:AI人工智能开发技术收集目录结构