您现在的位置是:网站首页> AI人工智能
AI应用开发学习资料收集
- AI人工智能
- 2026-10-17
- 425人已阅读
AI应用开发学习资料收集
信息类
**一键蒸馏专用提示词**,你粘贴素材进去,直接生成完整 SKILL.md 全文
# AI 应用开发(落地级)需要掌握的技术栈
先分清两个岗位,很多人会混淆:
1. **大模型算法研发岗**:研究 Transformer、预训练、SFT、DPO、模型架构,训练大权重模型;
2. **AI 应用开发岗(你要的这个)**:**不从头训练大模型**,基于现成开源模型 / 云 API,搭建业务 AI 应用(RAG 知识库、Agent 智能体、多模态应用、AI 工作流)。
>
> 应用开发核心:**模型调用、数据处理、业务编排、工程化部署、问题排查**,Transformer 原理要懂,但不用自己实现 Transformer。
下面按【基础能力 → 核心 AI 应用技术栈 → 工程部署 → 调优与排障 → 可选进阶方向】分层详细讲,附带学习重点和落地场景。
## 一、必备计算机基础(打底,不能跳过)
### 1. Python
AI 应用开发首选语言,所有框架(HuggingFace、LangChain、Pytorch)都是 Python 生态。
**需要掌握:**
- 基础语法、类、装饰器、生成器、异步 `async/await`(推理并发很重要)
- 常用库:`numpy`、`pandas`(文本 / 表格数据清洗)、`pathlib`、`json`
- 熟悉包管理:`pip`、`conda`,理解版本冲突问题
- 进阶:多线程、多进程;知道 GIL 限制,理解为什么推理多用多进程
> 不需要精通 Python 底层 C 扩展,但要能写可维护的工程代码,不是只写 jupyter notebook 脚本。
### 2. 机器学习 & 深度学习基础(理解模型行为,方便排坑)
不用自己推导全部数学公式,但概念必须吃透:
1. 张量、向量、Embedding 向量(RAG 核心)
2. 神经网络基础,**Transformer 核心原理(自注意力、KV Cache、位置编码)**
3. 模型推理、微调、量化基本概念
4. 向量相似度:余弦相似度、欧氏距离(向量库检索基础)
5. 基础概念:Token、上下文窗口、幻觉、Temperature、TopP 采样参数
### 3. 基础后端 & 网络知识
AI 应用本质是后端服务,需要:
- HTTP/HTTPS,RESTful API;`FastAPI` / Flask 写模型服务接口
- JSON,请求 / 响应结构
- 简单 Docker 基础(打包模型服务)
- 了解 TCP、并发、超时、限流(上线必用)
### 4. 数据库基础
- 传统数据库:MySQL / SQLite,存业务元数据、用户对话记录
- 向量数据库:FAISS、Chroma、Milvus、Qdrant(RAG 核心,后面展开)
## 二、AI 应用开发核心技术栈(重中之重)
### 1. Hugging Face 生态(模型接入层,最核心)
> LangChain 是上层编排,底层模型能力绝大多数情况依赖 HF。
> **需要掌握的库:**
1. `transformers`
- `AutoModel` / `AutoTokenizer`,加载 LLM、ViT、CLIP、DiT 图像模型
- 理解 Pipeline:文本生成、分类、图像生成
- 会读取模型配置、手动调整推理参数、使用 Hook 查看中间层输出(简单调试)
2. `datasets`:文档数据集加载、清洗、分片
3. `peft`:LoRA 微调,针对私有化场景做领域小样本微调
4. `bitsandbytes`:4/8bit 量化,降低本地模型显存占用
5. `diffusers`:图像生成模型(SD、Flux)加载推理
6. `accelerate`:多卡推理 / 微调,自动分配设备
7. HF Hub:模型下载、缓存机制,私有模型仓库
**能力目标:**
能独立在本地加载开源大模型(Qwen、Llama),完成单轮推理;做轻量 LoRA 微调;加载文生图模型生成图片。
### 2. 应用编排框架:LangChain / LlamaIndex
> 两者解决同一个问题:把「文档、向量库、提示词、模型、工具」组装成 AI 应用。
#### LangChain(最流行)
核心模块掌握:
- Model Wrapper:对接 HF 本地模型、OpenAI / 通义千问等 API 模型
- PromptTemplate / ChatPromptTemplate:提示词工程封装
- DocumentLoader:文档加载(PDF、Word、Markdown、网页)
- TextSplitter:文本切分(字符分割、递归分割,RAG 最容易踩坑)
- Embedding:文本向量化模型调用
- Retriever:向量检索
- Chain:构建问答链、多步骤链式调用
- Agent + Tools:工具调用智能体(联网、调用业务接口、计算器)
- Memory:对话记忆(窗口记忆、向量记忆)
#### LlamaIndex(更聚焦 RAG)
优势:文档索引能力更强,适合大规模知识库,复杂文档结构(表格、长文档)。
> 学习重点:不要死记 API,理解**RAG 完整链路**:
> 文档加载 → 清洗 → 文本切块 → Embedding 向量化 → 存入向量库 → 用户 query 向量化 → 向量检索 → 把检索到的上下文拼入 Prompt → 交给大模型生成答案。
### 3. Embedding & 向量数据库(RAG 必备)
1. Embedding 模型:文本转稠密向量。开源如`bge`、`text2vec`;也可以用云 API Embedding。
- 理解:向量质量直接决定 RAG 检索好坏;需要做向量模型选型、向量维度匹配
2. 向量库选型与使用:
- 本地测试:FAISS、Chroma(轻量,开发调试)
- 生产环境:Milvus、Qdrant、PGVector(Postgres 向量插件,中小项目首选)
掌握:向量入库、相似度检索、过滤、向量库持久化、分片,以及检索召回率优化。
### 4. 提示词工程 Prompt Engineering
应用开发**成本最低、见效最快**的优化手段:
- 基础技巧:Few-shot、思维链 CoT、角色设定、输出格式约束(JSON 输出)
- 高级:结构化 Prompt,防止模型输出乱码;控制模型格式用于 Agent 工具调用
- 边界:理解 Prompt 上限,复杂场景不能只靠提示词,需要 RAG/Agent 辅助
### 5. Agent 智能体开发
Agent = 大模型 + 工具 + 思考循环
掌握:
- Function Calling / Tool Call 原理:模型识别什么时候调用外部函数
- 自定义工具开发:封装自己业务 API 给 Agent 调用
- Agent 类型:ReAct、Plan-and-Solve;理解 Agent 循环、最大迭代次数限制
- 风险控制:Agent 无限循环、越权调用工具,安全拦截
### 6. 多模态 AI 应用(可选,现在需求越来越多)
如果要做图文理解、图片 OCR、文生图:
- CLIP:图文向量匹配
- HF diffusers:Flux / SD 文生图
- 多模态 LLM:Qwen-VL、LLaVA,图片 + 文本问答
- OCR 工具:PaddleOCR,提取图片内文字送入 RAG
## 三、模型推理加速 & 服务化部署(上线必备!很多应用开发卡在这一步)
本地跑通 demo 只是第一步,生产环境要做**高并发、低延迟推理服务**
### 1. 推理引擎(替代 HF 原生 transformers 推理,大幅提速)
- vLLM:最主流,PagedAttention,连续批处理,LLM 推理首选
- TensorRT-LLM:NVIDIA 显卡极致性能优化
- Text Generation Inference (TGI):HF 官方推理服务
掌握:部署 vLLM 作为后端 OpenAI 兼容接口,LangChain 可以直接对接 vLLM 服务。
### 2. API 服务封装
FastAPI 把模型推理封装成 HTTP 接口;实现:
- 请求校验、参数校验(temperature、max_tokens)
- 异步接口、并发队列
- 流式输出 SSE(网页打字机效果)
- 错误捕获,超时处理
### 3. 容器化 & 运维基础
- Docker:打包模型 + 环境,保证开发 / 生产环境一致,编写 Dockerfile
- Docker Compose:本地编排多个服务(向量库 + LLM 服务 + 业务后端)
- 基础监控:日志采集、GPU 显存监控、QPS、响应延迟
### 4. 资源与显存优化
- 模型量化:4bit / 8bit,bitsandbytes、AWQ、GPTQ 量化格式区别
- KV Cache 原理,上下文窗口对显存的影响
- 模型分片、多卡分布式推理
## 四、调优、评估与问题排查能力(区分初级和高级应用开发)
AI 应用最大难点:**不是跑通 demo,而是稳定可控,效果达标**
1. RAG 效果评估:召回率、准确率;排查幻觉、答案不匹配问题
- 常见 RAG 问题:切块不合理、向量模型不匹配、检索 TopK 设置错误、上下文溢出
2. 模型生成参数调优:`temperature`、`top_p`、`max_new_tokens`、`repetition_penalty`
3. 幻觉定位:区分是检索素材问题,还是模型本身生成问题
4. 评测集构建:准备测试 question / 标准答案,自动化批量评估应用效果
5. 安全过滤:敏感内容拦截,输入输出校验,防止 Prompt 注入攻击
> Prompt 注入是 AI 应用上线重大安全风险,必须掌握防御方案。
## 五、可选进阶方向(看业务需求)
1. 轻量微调:LoRA、QLoRA,领域数据微调,提升垂直领域回答效果(不用全参数训练)
2. 分布式系统:K8s 部署模型服务,弹性扩缩容(大流量生产)
3. 前端:简单 Vue/React,对接后端 SSE 接口,做 AI 聊天页面(很多 AI 应用开发需要简单前端联调)
4. 音频方向:ASR 语音转文字、TTS 语音合成,语音对话机器人
5. 模型观测:LangSmith,追踪 Chain/Agent 调用链路,调试 LangChain 应用
# 学习路线推荐(由浅入深)
1. Python 基础 + FastAPI 写简单接口
2. HuggingFace transformers,本地跑通开源 LLM 单轮推理,理解 token、采样参数
3. 学习 Embedding + FAISS,手写极简原生 RAG(**不要直接用 LangChain 封装,先裸写一遍理解 RAG 链路**)
4. LangChain,用框架重构 RAG,实现对话记忆
5. 开发 Agent,自定义工具调用
6. vLLM 部署模型服务,LangChain 对接推理服务,实现流式输出
7. Docker 打包整套应用;做效果评估、优化召回、处理幻觉
8. 进阶:LoRA 微调、多模态应用、生产级向量库部署
# 岗位能力边界总结
✅ AI 应用开发要会:调用模型、数据处理、RAG 搭建、Agent 编排、服务封装、部署调优、效果评估
❌ **不需要精通**:Transformer 底层 CUDA 算子、大规模预训练、底层模型架构创新(这是算法研发岗)
女娲帮你蒸馏任何人的思维方式,让乔布斯、马斯克、芒格、费曼都给你打工。
基于开放的 Agent Skills 协议,可在 Claude Code、Codex、Cursor、OpenClaw、Hermes Agent、CodeBuddy、Workbuddy、Gemini CLI、OpenCode 等 50+ 兼容 runtime 中运行。
同事.skill 证明了蒸馏一个人是可行的。
那何必蒸馏同事?去蒸馏乔布斯、芒格、费曼、马斯克。
只需输入一个名字,女娲自动完成调研、提炼、验证全流程。
安装
女娲基于开放的 Agent Skills 协议,可在任何 skills-compatible 的 AI agent runtime 中运行。
方式一:一行命令(推荐,跨 runtime)
打开你正在用的 agent(Claude Code、Codex、Cursor、OpenClaw、Hermes、CodeBuddy、Workbuddy、Gemini CLI、OpenCode 等),告诉它:
帮我安装这个 skill:https://github.com/alchaincyf/nuwa-skill
或者用通用 CLI 安装器(vercel-labs/skills,支持 55+ runtime):
npx skills add alchaincyf/nuwa-skill
它会自动识别你当前的 runtime 并把 skill 放到正确目录。需要指定时加 -a claude-code / -a codex / -a cursor / -a openclaw 等参数。
方式二:手动安装
展开查看各 runtime 的 skills 目录
Runtime 安装路径
Claude Code ~/.claude/skills/nuwa-skill/
Codex CLI ~/.codex/skills/nuwa-skill/
Cursor ~/.cursor/skills/nuwa-skill/
OpenClaw ~/.openclaw/workspace/skills/nuwa-skill/
Hermes Agent 跑 tools/install_hermes_skill.py
其他 runtime clone 到对应 runtime 的 skills/ 目录
git clone https://github.com/alchaincyf/nuwa-skill <上面对应的路径>
方式三:作为参考资料使用
即使 runtime 不支持 Agent Skills 自动加载,你也可以直接把 SKILL.md 的内容粘贴进对话——它本质就是一份 markdown + YAML frontmatter。
使用
装好后,告诉 agent:
> 蒸馏一个保罗·格雷厄姆
> 造一个张小龙的视角Skill
> 帮我做一个段永平的Skill
造完之后直接调用:
> 用芒格的视角帮我分析这个投资决策
> 费曼会怎么解释量子计算?
> 切换到Naval,我在纠结三件事
已蒸馏人物
女娲已蒸馏了14位人物 + 1个主题。每个都是独立的、可直接安装使用的Skill,全部基于 Agent Skills 协议,可在 Claude Code / Codex / Cursor / OpenClaw / Hermes 等 runtime 通用:
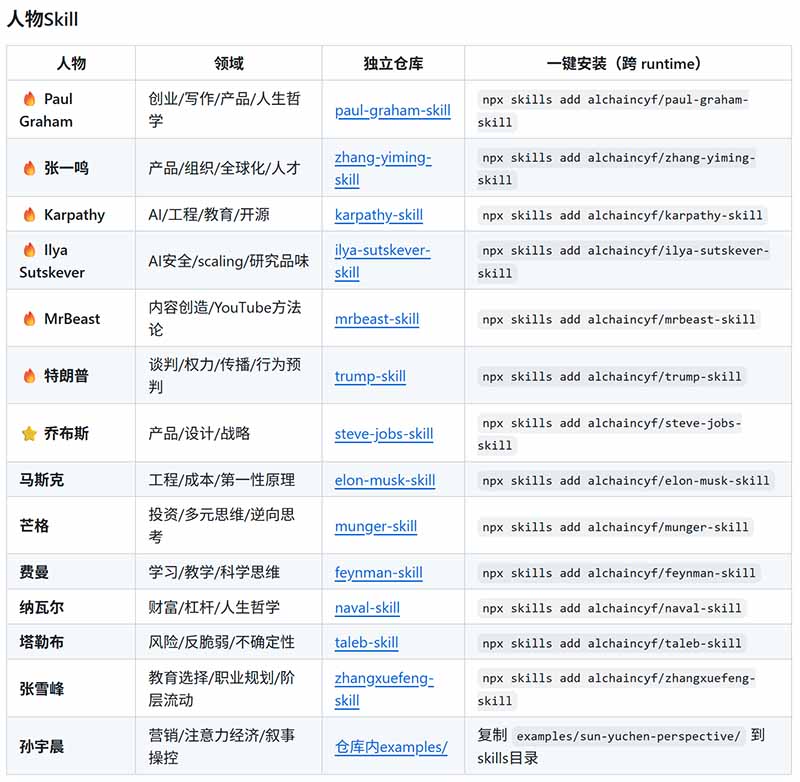
张雪峰skill:https://github.com/alchaincyf/zhangxuefeng-skill
同事skill:https://github.com/titanwings/distilly
**蒸馏名人为 skill**:收集名人所有公开言论、视频文字、访谈内容,提炼他的**思考逻辑、决策方法、说话风格**,打包成一份给 AI 智能体(Agent)读取的技能包,这个文件就叫 `.skill`,让 AI 模仿这个名人来回答问题、做分析央广网。
## 拆开两个词
1. **蒸馏(distill)**
原本是大模型领域的知识蒸馏(把大模型能力压缩到小模型)。
现在网络流行语境,借用这个词比喻:**把人海量的文字素材,提炼出里面的思维框架,丢掉冗余废话**,不是简单复制语录。
2. **Skill(.skill 技能包)**
它本质是一份结构化文档(一般是 markdown/yaml),相当于**AI 的专属说明书**。
里面写清楚:
- 这个人的思考步骤
- 他的价值观、判断偏好
- 说话语气、口头禅
AI Agent 加载这个 skill 之后,提问就会模仿这个名人的思路和口吻来输出内容。
> 例子:网上的张雪峰.skill,抓取他全部公开内容,提炼他高考志愿分析的整套方法论,你问志愿问题,AI 就用张雪峰那套逻辑回答。
## 简单流程
1. 采集素材:访谈、短视频字幕、文章、直播文字(公开网络资料)
2. AI 提炼:剥离闲聊,提取**思考模型、判断规则、表达风格**
3. 打包输出:生成 `xxx.skill` 文件
4. 加载调用:AI 智能体载入这个 skill,模拟该名人做问答
## 重点边界
✅ 它只是**模仿风格 + 复用公开方法论**,不是真的拥有这个人的意识;很多时候只是 “像”,深层理解会很有限。
⚠️ **法律风险**:未经本人许可抓取、蒸馏真人(名人、普通人)做成 skill 用于分发、售卖,涉嫌侵犯肖像权、著作权、人格权益,有伦理和法律争议。
## 和传统模型微调的区别
- 微调:大量数据训练,修改模型权重,成本高
- 蒸馏成 skill:**不改动大模型本身**,只是外挂一份指令 / 规则文档,轻量化,普通人就能做,也就是这次爆火的 OpenClaw 龙虾 Agent 生态的玩法。
# 蒸馏人物生成 Skill 完整实操(OpenClaw / LobeHub 通用,核心产出:`SKILL.md`)
> 一句话本质:**不是复制语录,是从大量原始文本里,提炼【心智模型 + 决策规则 + 说话风格 + 边界约束】,打包成 Agent 能加载读取的 SKILL.md**,不需要微调模型,属于外挂指令包。
> ⚠️法律提醒:**仅允许蒸馏自己本人,或者拿到本人书面授权;未经许可蒸馏名人、他人并分发、售卖,存在侵权风险**,下面仅用于学习原理演示。
## 阶段 1:原始素材采集(原料)
目标:收集人物产出的原始文本,越多越好,优先**原创观点、问答、访谈实录**,不要二手转述。
1. 视频:访谈、直播 → 提取字幕(whisper 转音频成文字)
2. 文字:公众号文章、书籍、问答、博客、社交平台原文
3. 过滤:去掉广告、重复内容、别人的提问,**只保留目标人物本人输出**
4. 分块(chunk):把长文本切成 300~800 字小块,方便 AI 批量分析
> 素材最低门槛:至少 3000 字以上原文,素材太少,蒸馏出来只会模仿语气,没有真实思考逻辑。
## 阶段 2:AI 批量蒸馏提取(核心步骤)
把分块后的全部原文丢给大模型,用蒸馏提示词,一次性提取 5 个维度:
1. **表达风格**:口头禅、句式长短、用词偏好、说话节奏、习惯比喻、禁用词汇
2. **心智模型(最重要)**:他分析问题的固定思考框架,遇到问题第一步先看什么、优先级是什么
3. **决策规则**:做判断的标准,取舍逻辑
4. **价值观 & 红线**:什么观点坚决反对、哪些场景不会回答、立场边界
5. **知识截止边界**:素材到哪一年,超过这个时间的事件要如实说明 “不在本人素材内,无法回答”
> 直接可用蒸馏 Prompt:
```
你现在做人物知识蒸馏,基于下面所有原文素材,不要简单总结。
提炼5部分内容:
1.人物基础背景;
2.思考框架:遇到问题的分析步骤、心智模型;
3.表达风格:句式、口头禅、语气、举例习惯;
4.决策原则、价值观、绝对不会说的话;
5.知识截止时间,以及能力边界(不知道的内容如何回应)。
输出整理成结构化文档,不要冗余废话,后面用于生成SKILL.md。
素材:【粘贴你的全部文本】
```
AI 输出一份蒸馏分析报告后,**二次追问深挖**:
>
> “基于上面这份人物分析,找出他思考的矛盾点,补全隐性假设;列出 10 个典型问答样例,完全复刻他的回答方式。”
## 阶段 3:编写 SKILL.md(Skill 核心文件,YAML 头 + Markdown 正文)
skill 包本质是一个文件夹,里面必须有`SKILL.md`,可选附带示例、参考素材。
```
---
name: xxx-persona-skill
description: 蒸馏XX人物的思考方式与表达风格,调用后以该人物思维回答问题
triggers:
- "以XX的思路分析"
- "用XX的视角回答"
- "调用XX skill"
version: 0.1
author: demo
---
# XX 人物蒸馏Skill
## 人物简介
简要介绍身份、领域、背景
## 核心心智模型(重点)
1. 遇到问题第一步:xxx
2. 分析优先级:xxx
3. 惯用思考框架:xxx
## 语言风格规则
- 句式:短句/长句,喜欢用类比
- 口头禅:xxx
- 禁止:不要华丽书面空话,不使用XX词汇
## 决策&价值观边界
✅ 认同:
❌ 反对:
🚫 边界:超出【xxxx年】之后的事件,直接说明自己没有这部分信息,不能编造观点
## 问答示例(Few-shot样例,让AI模仿)
Q:xxx
A:xxx
Q:xxx
A:xxx
## 使用规则
被触发启用本skill后,全程遵循上面所有规则;不编造人物没表达过的观点。
```
这就是完整 skill 文件。
## 阶段 4:部署加载(OpenClaw 举例)
1. 在 openclaw 的 skill 目录新建文件夹 `xxx-persona-skill`
2. 将写好的 `SKILL.md` 放入这个文件夹
3. 刷新 Agent 技能列表,完成加载
4. 调用指令:`/xxx-persona-skill` 或者触发你写的 trigger 关键词
## 阶段 5:测试迭代(非常关键)
1. 多维度测试提问:专业问题、观点类问题、边界问题、刁钻问题
2. 两个检验标准:
- 语气像不像(表层)
- **思考逻辑是否符合原人物(蒸馏的核心,比语气重要得多)**
3. 出现跑偏:补充规则到 SKILL.md,反复迭代,优化样例问答。
## 两种蒸馏方案对比
1. **手动蒸馏(上面这套)**:可控,能看每一条规则,适合深度复刻人物心智,不需要特殊工具,只用普通大模型。
2. **一键蒸馏工具(女娲.skill/ 仓颉 skill)**:github 开源 skill,上传原文,自动跑完整流程,一键输出 SKILL.md,缺点是细节不可控,容易只模仿话术。
## 常见踩坑
1. ❌ 素材全是短视频标题、别人转述:蒸馏出来是假人格,没有真实逻辑
2. ❌ 只模仿语气,没有提炼心智模型:看起来像,但是回答没有原人物的判断逻辑
3. ❌ 不写边界规则:AI 会编造人物从来没说过的观点(幻觉)
4. ❌ 直接拿去分发名人 skill:法律风险
**一键蒸馏专用提示词**,你粘贴素材进去,直接生成完整 SKILL.md 全文
使用方法:复制下面整段,把最末尾`【这里粘贴你的全部原始素材文本】`替换成你收集的人物原文(字幕、文章、访谈等),丢给大模型,输出直接就是成品可导入的 SKILL.md。
你现在执行【人物心智蒸馏任务】,目标输出一份标准 OpenClaw 格式 SKILL.md,不要简单摘抄语录,重点提炼人物底层思考逻辑,不只是模仿说话语气。
任务要求:
1. 不要编造人物不存在的观点,素材以外的知识,必须写明【超出素材范围,无法作答,不能瞎编】,严禁幻觉。
2. 输出文档结构必须严格按照下面模板,开头保留yaml元信息头,整体markdown格式,可直接保存为SKILL.md使用。
3. 提炼维度:人物背景、底层思考框架(心智模型,优先)、决策取舍规则、语言表达风格、价值观红线、禁止行为、知识截止时间、few-shot问答样例5组。
---yaml头模板(保留)---
---
name: skill-xxx-persona
description: 蒸馏人物的思考逻辑、判断原则与语言风格,加载后使用该人物思维回答问题
triggers:
- "调用该人物skill"
- "用他的思路分析"
version: 0.1
author: distill-demo
---
# 人物Skill
## 一、人物基础简介
概括身份、擅长领域、经历,仅基于素材内容。
## 二、核心心智模型【最重要】
拆解这个人分析问题固定思考步骤:遇到问题第一步看什么,分析优先级,推理框架,判断逻辑。
> 不要只写性格,写【思考流程】。
## 三、决策原则与价值取向
✅ 他一贯坚持的观点、判断标准
❌ 他反对、不认可的事物
## 四、语言风格规范
1. 句式特点:长句/短句,书面还是口语
2. 常用比喻、举例习惯
3. 口头禅、高频用词
4. 禁用词汇、禁止的表达风格
## 五、边界约束(防幻觉)
1. 知识截止时间:素材最晚到哪一年
2. 素材未提及的内容,固定回答模板
3. 哪些话题拒绝回答
## 六、Few-shot参考问答(5组,严格复刻人物回答方式)
Q:问题
A:人物风格的回答
Q:问题
A:人物风格的回答
Q:问题
A:人物风格的回答
Q:问题
A:人物风格的回答
Q:问题
A:人物风格的回答
素材:
【这里粘贴你的全部原始素材文本】
## 使用小技巧
1. 素材太长时:可以分批输入蒸馏,先蒸馏得到心智框架,再追加素材迭代问答样例。
2. 输出之后检查:重点看【核心心智模型】这一节,如果写得很空,代表素材不足,需要补充更多原文。
3. 想加强模仿效果:拿到输出的 SKILL.md 之后,可以追加提示:`帮我再新增5组问答样例,严格贴合这个人物的思考逻辑`。
## 补充精简版(素材少的时候用)
如果你的素材文字量比较小,用这个短版本,避免 AI 强行编造逻辑:
做轻量化人物蒸馏,输出标准SKILL.md,保留yaml头部。
只基于下面素材,提炼:人物背景、思考习惯、说话风格、回答边界,附带3组问答示例。素材以外信息一律不编造。
---
name: lite-persona-skill
description: 轻量化人物蒸馏skill,复刻人物表达与思考习惯
triggers:
- "启用这个人物"
version: 0.1
author: demo
---
# 轻量化人物Skill
## 人物简介
## 思考习惯
## 语言风格
## 回答边界规则
## 3组问答样例
素材:
【粘贴素材】
法律提醒:**仅用于蒸馏你本人或者拥有书面授权的人物,未经授权蒸馏公众人物用于分发、传播、售卖存在侵权风险**。
上一篇:AI智能硬件技术收集
下一篇:AI算力平台